A ProBrain é uma empresa brasileira de neurotecnologia voltada às áreas de saúde e educação. A companhia desenvolve soluções para estimulação do processamento auditivo e treinamento cerebral, com produtos direcionados a fonoaudiólogos, professores, empresas, pais e usuários de diferentes faixas etárias.
Com sede em Sorocaba, no estado de São Paulo, a empresa teve origem na prática clínica das fonoaudiólogas Ingrid Gielow e Diana Faria. Seu portfólio reúne três soluções: o Afinando o Cérebro, plataforma de jogos interativos para estímulo da comunicação, da memória e da atenção; o AudioFoco Corp, aplicativo multiplataforma com inteligência artificial para triagem e personalização de treinos auditivos; e o AudBility, plataforma web para triagem de habilidades auditivas em cerca de 20 minutos.
A ProBrain baseia o desenvolvimento de seus produtos em pesquisa científica e declara que mais de 60 estudos foram conduzidos com suas soluções. A empresa associa a essas pesquisas instituições como UNICAMP, SESI e CEV, e relaciona sua atuação ao estímulo de conexões neurais ligadas à atenção, à memória e à compreensão auditiva.
A ProBrain precisava disponibilizar em seu site de jogos um assistente virtual de inteligência artificial, capaz de responder às perguntas frequentes dos usuários, entre elas recomendações de jogos, informações sobre os planos disponíveis e esclarecimentos sobre as funcionalidades da plataforma. O objetivo era oferecer suporte imediato ao usuário no próprio ambiente da plataforma, sem intermediação humana para as dúvidas recorrentes.
A restrição central era de custo, e ela incidia sobre uma decisão de arquitetura específica: a base vetorial. O Amazon OpenSearch Service (Amazon OpenSearch Service), opção usual para esse componente, pressupõe a operação de um cluster gerenciado cujo custo independe do tamanho da base indexada. Para um acervo reduzido, de aproximadamente 100 páginas de documentação, esse modelo resultava em custo desproporcional ao volume real de dados, o que inviabilizava a alternativa para o orçamento do cliente.
O desafio, portanto, era duplo. De um lado, era necessário preservar a qualidade da recuperação de informação e a coerência das respostas, requisito sem o qual o assistente não cumpriria sua função. De outro, a solução precisava operar com baixo custo, escalar conforme a demanda do site e permanecer de simples manutenção, condição para que se sustentasse no orçamento de uma startup de pequeno porte.
A Nuvme desenhou e implementou uma solução de geração aumentada por recuperação (Retrieval-Augmented Generation, RAG) em arquitetura totalmente serverless, orientada por uma decisão de projeto central: substituir a base vetorial gerenciada por uma alternativa de baixo custo, proporcional ao tamanho real do acervo. Essa escolha respondeu diretamente à restrição orçamentária descrita no cenário inicial, sem abrir mão da qualidade de recuperação de informação.
A base de conhecimento, de aproximadamente 100 páginas, foi segmentada em trechos (chunks) e convertida em vetores por meio do modelo Amazon Titan Embeddings, executado no Amazon Bedrock. Em lugar de um repositório vetorial gerenciado, os vetores resultantes foram armazenados em um arquivo no formato JSON no Amazon Simple Storage Service (Amazon S3), que passou a operar como base vetorial da solução. A atualização dessa base foi automatizada: cada novo upload de conteúdo ao bucket aciona uma função AWS Lambda que processa os textos, gera os embeddings no Amazon Bedrock e atualiza o arquivo vetorial no próprio bucket, o que mantém a manutenção simples e sem intervenção manual.
No fluxo de consulta, a pergunta enviada pelo usuário no site aciona, por meio do Amazon API Gateway, uma função AWS Lambda que converte a pergunta em vetor, compara esse vetor com os armazenados no Amazon S3 por similaridade de cosseno e seleciona os trechos mais relevantes do acervo. Esses trechos são enviados, junto da pergunta do usuário, ao Amazon Bedrock, que gera a resposta final com o modelo Amazon Nova Lite. A continuidade das interações é preservada pelo parâmetro chat_history nas chamadas à API, o que permite ao modelo manter o contexto ao longo da conversa.
A Nuvme foi responsável pelo desenho completo da arquitetura, o que abrangeu a definição da abordagem de baixo custo, o desenvolvimento das funções AWS Lambda e a integração entre o Amazon Bedrock, o Amazon API Gateway e o Amazon S3. A participação do cliente restringiu-se ao fornecimento do conteúdo-fonte da base de conhecimento, sem envolvimento no desenvolvimento técnico. A qualidade da solução foi verificada por avaliação iterativa ao longo do desenvolvimento, com testes de recuperação dos trechos relevantes e ajuste sucessivo da estratégia de segmentação até a obtenção de respostas consistentes.
Quanto ao controle de qualidade das respostas e à segurança, a Nuvme adotou práticas de mitigação de alucinação e de contenção de escopo: o Amazon Bedrock é instruído, por meio de prompt, a responder apenas com base no conteúdo recuperado da base vetorial, o que restringe o modelo ao acervo fornecido e evita o preenchimento de lacunas com informação externa. O acesso aos dados seguiu os controles padrão da AWS, com bucket do Amazon S3 privado, permissionamento via AWS Identity and Access Management (AWS IAM) e criptografia em repouso padrão do Amazon S3. O desenvolvimento seguiu as boas práticas de uso responsável de IA generativa recomendadas pela AWS para arquiteturas baseadas em Amazon Bedrock. Não há, até o momento, política formal documentada de IA responsável; sua formalização está prevista como próximo passo de maturidade do serviço.
Modelos de fundação, executados no Amazon Bedrock:
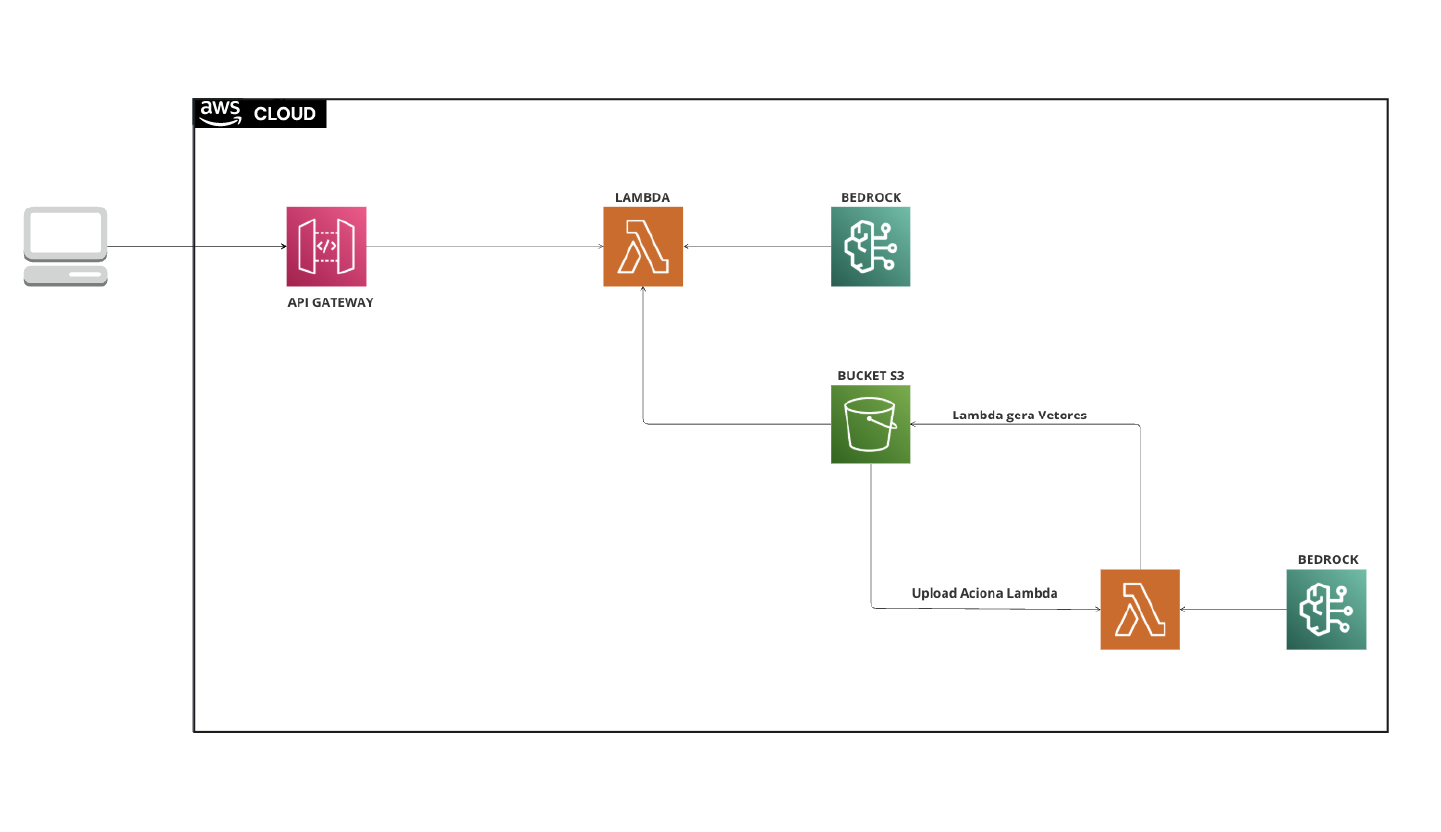
A solução foi estruturada em arquitetura serverless, organizada em dois fluxos complementares: um de ingestão e atualização da base de conhecimento e outro de consulta em tempo de uso. Todos os componentes são serviços gerenciados da AWS, sem infraestrutura dedicada de servidores.
No fluxo de ingestão, o conteúdo-fonte é enviado a um bucket do Amazon Simple Storage Service (Amazon S3). Cada novo upload aciona uma função AWS Lambda responsável por segmentar o texto em trechos, gerar os vetores correspondentes por meio do modelo Amazon Titan Embeddings no Amazon Bedrock e gravar o resultado em um arquivo no formato JSON no próprio bucket. Esse arquivo JSON constitui a base vetorial da solução e dispensa a operação de um repositório vetorial gerenciado. O acionamento automático a cada upload mantém a base atualizada sem intervenção manual.
No fluxo de consulta, a pergunta enviada pelo usuário no site do cliente chega ao Amazon API Gateway, que aciona uma função AWS Lambda. Essa função converte a pergunta em vetor, também por meio do Amazon Titan Embeddings, e a compara com os vetores armazenados no Amazon S3 pelo cálculo de similaridade de cosseno, o que permite selecionar os trechos mais relevantes do acervo. Os trechos selecionados são enviados, junto da pergunta original, ao Amazon Bedrock, que gera a resposta final com o modelo Amazon Nova Lite. A resposta retorna ao usuário pelo mesmo caminho, e o parâmetro chat_history preserva o contexto entre as interações sucessivas da conversa.
O controle de acesso entre os componentes é feito pelo AWS Identity and Access Management (AWS IAM), com o bucket do Amazon S3 mantido privado e com criptografia em repouso padrão do serviço. Todo o processamento ocorre dentro do ambiente AWS, sem tráfego dos dados para serviços de terceiros externos ao perímetro da nuvem.
O projeto entregou à ProBrain um assistente virtual funcional, integrado ao site do cliente, capaz de responder às perguntas frequentes dos usuários sobre jogos, planos e funcionalidades com respostas contextualizadas e geradas em poucos segundos. Por tratar-se de uma funcionalidade nova, e não da substituição de um processo manual anterior, o resultado se caracteriza pela disponibilização de uma capacidade de atendimento automático que a plataforma não possuía, e não por um ganho comparativo sobre um cenário prévio.
O eixo central do resultado é a viabilidade econômica da solução. A arquitetura serverless, com base vetorial mantida em arquivo no Amazon Simple Storage Service (Amazon S3) em lugar de um repositório vetorial gerenciado, permitiu operar o assistente a um custo estimado entre 5 e 10 dólares mensais, considerada uma média de aproximadamente 10.000 chamadas por mês. Essa estimativa de Custo Total de Propriedade abrange o processamento dos modelos para geração de embeddings e de respostas, a execução das funções AWS Lambda, o armazenamento no Amazon S3 e o uso do Amazon API Gateway. A abordagem tornou viável, dentro do orçamento do cliente, um caso de uso que o Amazon OpenSearch Service, alternativa avaliada e descartada, oneraria de forma desproporcional ao tamanho da base. Não há, contudo, o custo daquela alternativa mensurado para comparação direta.
A qualidade da recuperação de informação se sustentou em duas decisões de projeto verificadas durante o desenvolvimento: a segmentação criteriosa do acervo em trechos e o uso de embeddings para a busca semântica, que garantiram precisão nas respostas; e a preservação do histórico da conversa pelo parâmetro chat_history, que deu continuidade de contexto às interações. A arquitetura serverless assegura que a solução escale conforme a demanda do site e permaneça de simples manutenção, uma vez que a atualização da base ocorre de forma automática a cada novo upload de conteúdo.
No projeto da ProBrain, a Nuvme entregou um assistente virtual de IA generativa para o site de jogos do cliente, em arquitetura de geração aumentada por recuperação totalmente serverless. A decisão de projeto que definiu o resultado foi a substituição da base vetorial gerenciada por uma base mantida em arquivo no Amazon Simple Storage Service, o que viabilizou o caso de uso dentro do orçamento de uma startup de pequeno porte, com custo mensal estimado entre 5 e 10 dólares. A solução disponibilizou à plataforma uma capacidade de atendimento automático que ela não possuía, com respostas contextualizadas e manutenção simplificada pela atualização automática da base. Para a Nuvme, projetos como este demonstram nossa capacidade de desenhar arquiteturas de IA generativa ajustadas a restrições de custo concretas, sem comprometer a qualidade da recuperação de informação.