A Datarisk é uma empresa brasileira de tecnologia que desenvolve soluções de Machine Learning e Inteligência Artificial voltadas à tomada de decisão. A companhia cria modelos preditivos para análise de dados, com aplicação em setores como instituições financeiras, varejo, saúde, marketing, supply chain e people analytics.
A empresa tem atuação no mercado desde 2017, com sede em Florianópolis - SC, e conta com mais de 70 colaboradores, a maioria dedicada a áreas de dados e tecnologia, e atende clientes em diversas verticais de negócio. Entre suas soluções estão a plataforma de MLOps, para treino, implementação e monitoramento de modelos; o Model as a Service (MaaS), com modelos customizados hospedados em nuvem; o ChurnAI, voltado à identificação de clientes com risco de cancelamento; e serviços de consultoria e de agentes de IA.
A empresa descreve sua missão como a democratização da ciência de dados e a simplificação de decisões baseadas em dados. Entre os reconhecimentos citados no site estão programas como Google for Startups. Sua carteira reúne clientes dos setores financeiro e de varejo.
Antes da implementação da solução, a equipe técnica do cliente enfrentava dificuldades para compreender o comportamento do ambiente produtivo a partir dos logs de aplicação e dos logs de deployment gerados pelo FluxCD. Cada investigação exigia um esforço manual de correlação, no qual a equipe precisava aproximar os eventos de deployment do GitOps dos comportamentos observados na aplicação até localizar a causa raiz de cada problema.
Esse método tornava o troubleshooting lento e o mantinha refém do conhecimento tácito de quem conduzia a análise. Na ausência de um mecanismo padronizado de correlação, a identificação da causa raiz dependia da experiência individual do profissional responsável, o que fragilizava a previsibilidade do processo e concentrava em poucas pessoas a capacidade de resposta a incidentes.
A Nuvme implementou uma solução de análise automatizada de logs e eventos baseada no K8sGPT, integrado ao cluster Kubernetes e apoiado no Amazon Bedrock como motor de análise. A solução avalia de forma automática os logs do FluxCD e os eventos do Kubernetes, correlaciona esses eventos e fornece explicações contextualizadas sobre erros e problemas potenciais no ambiente. Com isso, reduz o tempo necessário para identificar e resolver problemas e elimina parte do esforço manual de correlação de logs antes conduzido integralmente pela equipe técnica do cliente.
"Optamos por executar o K8sGPT dentro do próprio cluster Kubernetes do cliente, com o Amazon Bedrock como motor de análise. Essa decisão manteve os dados de log e as informações do cluster no ambiente AWS do cliente e circunscreveu a atuação da ferramenta ao diagnóstico operacional."
Peter König, Co-founder e CTO da Nuvme
A Nuvme foi responsável pela implementação completa, o que abrangeu a configuração do Amazon Bedrock, a arquitetura de deployment do K8sGPT dentro do cluster e o desenho da integração que conecta as fontes de log, da aplicação e do FluxCD, ao motor de análise.
"Como implantamos a solução em múltiplos ambientes, estabelecemos um padrão de configuração e validação replicável entre clientes. Esse padrão nos dá uma referência de qualidade sobre como a solução é configurada e verificada a cada nova implementação."
Peter König, Co-founder e CTO da Nuvme
O escopo de atuação do K8sGPT é restrito ao diagnóstico do cluster, limitado aos dados de log e de eventos já presentes no ambiente do próprio cliente. Essa contenção mantém a saída da ferramenta circunscrita a conteúdo técnico e operacional e reduz o risco de uso indevido associado a aplicações de IA generativa de propósito mais amplo. O desenvolvimento seguiu as boas práticas de uso responsável de IA generativa recomendadas pela AWS para arquiteturas baseadas em Amazon Bedrock, com o escopo de análise deliberadamente limitado aos dados operacionais e de diagnóstico do próprio cluster.
A solução opera sobre o cluster Kubernetes do cliente, orquestrado pelo Amazon EKS com capacidade de computação provida pelo Amazon EC2. O K8sGPT, componente responsável pela análise, é executado dentro do próprio cluster, o que mantém a operação no perímetro do ambiente AWS do cliente e dispensa o envio de dados a serviços externos.
O K8sGPT consome duas fontes de dados já presentes no cluster: os logs de deployment gerados pelo FluxCD e os eventos do Kubernetes. A partir desses insumos, a solução aciona o Amazon Bedrock como motor de análise, que correlaciona os eventos e produz explicações contextualizadas sobre erros e problemas potenciais do ambiente. O desenho da integração que conecta as fontes de log ao motor de análise foi definido pela Nuvme, assim como a configuração do Amazon Bedrock e a arquitetura de implantação do K8sGPT no cluster.
O escopo de atuação do K8sGPT é restrito ao diagnóstico do cluster e limitado aos dados de log e de eventos do próprio ambiente, o que circunscreve a saída da ferramenta a conteúdo técnico e operacional. Os logs e as informações do cluster não deixam o perímetro da nuvem AWS em nenhuma etapa do fluxo.
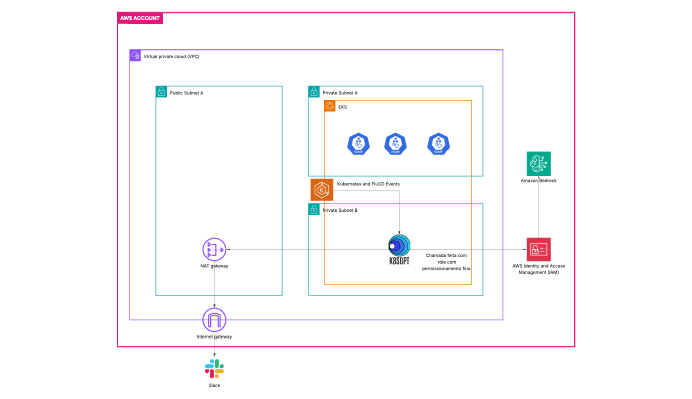
A solução implementada pela Nuvme atuou diretamente sobre a origem do problema descrito no cenário inicial: a correlação manual entre os eventos de deployment do FluxCD e os logs da aplicação, até então necessária para localizar a causa raiz de cada incidente. Com o K8sGPT a expor explicações de causa raiz de forma automática e em tempo real, essa etapa deixou de depender de esforço manual, o que retirou do fluxo de troubleshooting a atividade mais custosa e mais suscetível à variação entre profissionais.
"Com o diagnóstico automático de causa raiz, deixamos de concentrar em poucas pessoas a capacidade de resposta a incidentes. A identificação do problema passou a seguir um mecanismo padronizado, o que tornou o processo mais previsível para a nossa equipe técnica."
Joney Augusto Palma, Co-founder e CPTO da Datarisk
O ganho mais direto foi a redução da dependência do conhecimento tácito na resolução de incidentes. A identificação da causa raiz, antes condicionada à experiência individual de quem conduzia a investigação, passou a contar com um mecanismo padronizado de análise, o que ampliou a previsibilidade do processo e distribuiu de forma mais uniforme a capacidade de resposta da equipe técnica.
A solução foi implantada em múltiplos ambientes de clientes, o que permitiu à Nuvme consolidar um padrão de configuração e validação replicável. Nesses ambientes, observamos um output diagnóstico consistente e confiável, o que sustenta a maturidade do padrão de implementação estabelecido pela Nuvme e a sua aplicabilidade a diferentes contextos operacionais.
"A escolha pela Nuvme considerou o domínio técnico sobre o ambiente Kubernetes e sobre a arquitetura da solução. A implementação atendeu ao que precisávamos: explicações contextualizadas sobre os problemas do ambiente, a partir dos dados já presentes no nosso próprio cluster."
Joney Augusto Palma, Co-founder e CPTO da Datarisk
No projeto da Datarisk, a Nuvme substituiu a correlação manual de logs e eventos por uma solução de IA generativa na AWS, desenhada e implementada de ponta a ponta. A solução opera dentro do próprio cluster Kubernetes do cliente e apresenta explicações de causa raiz de forma automática, o que reduziu a dependência do conhecimento tácito na resolução de incidentes e ampliou a previsibilidade do processo de troubleshooting. Implantada em múltiplos ambientes, a solução deu à Nuvme um padrão de configuração e validação replicável entre clientes. Para a Nuvme, entregas como esta demonstram nossa capacidade técnica em arquiteturas de IA generativa aplicadas a operações de Kubernetes e caracterizam nossa atuação como parceiro de arquitetura em ambientes produtivos.